8 min read
En el post de Event Sourcing vs CRUD mencionamos a CQRS como el complemento natural, sin desarrollarlo.
Le toca su propio espacio, porque resuelve un problema muy común incluso en sistemas que no usan Event Sourcing en absoluto.
Tenés un catálogo de productos. Las escrituras son poco frecuentes: un producto se actualiza una vez al día, tal vez.
Las lecturas son masivas: miles de usuarios consultando el catálogo por segundo, filtrando por categoría, ordenando por precio, buscando por texto.
Si usás el mismo modelo de datos — las mismas tablas, las mismas entidades — para ambas operaciones, terminás optimizando para un caso a costa del otro.
Índices que aceleran las búsquedas complejas de lectura ralentizan las escrituras.
Un modelo normalizado que protege la integridad en la escritura obliga a joins costosos en cada lectura.
CQRS (Command Query Responsibility Segregation — Segregación de Responsabilidades de Comandos y Consultas) resuelve esto separando los dos modelos por completo.
¿Qué es CQRS?
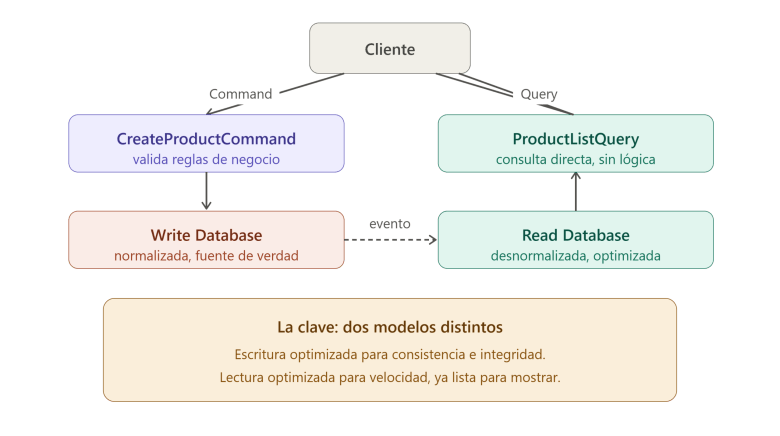
La idea parte de un principio simple: las operaciones que cambian el estado (comandos) y las que solo lo consultan (queries) tienen necesidades completamente distintas, así que no tienen por qué compartir el mismo modelo de datos.
- Lado de comandos (write model): optimizado para validar reglas de negocio e integridad. Normalizado, con las restricciones que garantizan consistencia.
- Lado de consultas (read model): optimizado para velocidad de lectura. Desnormalizado, con los datos ya en la forma exacta en que la interfaz los va a mostrar — sin necesidad de joins ni transformaciones adicionales.
Los cambios en el lado de escritura se propagan al lado de lectura de forma asíncrona, típicamente mediante eventos — la misma idea de propagación que vimos en el post de Outbox Pattern.
El diagrama
Guía paso a paso
Paso 1 — Separar comandos de consultas explícitamente en el código
Un comando (CreateProductCommand, UpdatePriceCommand) representa una intención de cambio.
Una consulta (GetProductByIdQuery, SearchProductsQuery) representa una intención de lectura.
Nunca deberían mezclarse en el mismo método.
Paso 2 — Diseñar el modelo de escritura para integridad
Normalizado, con las validaciones de negocio centralizadas. Este modelo es la fuente de verdad.
Paso 3 — Diseñar el modelo de lectura para el caso de uso exacto
Desnormalizado, con los datos ya combinados en la forma que la pantalla necesita mostrar.
Podés tener múltiples modelos de lectura distintos para distintas vistas del mismo dato.
Paso 4 — Propagar los cambios de forma asíncrona
Cuando el comando modifica el modelo de escritura, se publica un evento.
Un proceso separado consume ese evento y actualiza el modelo de lectura.
Paso 5 — Aceptar la consistencia eventual
Entre el momento en que se ejecuta un comando y el momento en que el modelo de lectura refleja ese cambio, hay una ventana — típicamente milisegundos, pero existe.
Tu interfaz de usuario y tus usuarios necesitan poder tolerar eso.
El código
Implementamos CQRS para un catálogo de productos: un lado de comandos que valida y persiste, y un lado de consultas con un modelo de lectura desnormalizado, sincronizado mediante eventos.
import lombok.AllArgsConstructor;
import lombok.Getter;
import java.util.*;

// --- Modelo de escritura: normalizado, fuente de verdad ---

@Getter
class Product {
    private final String id;
    private String name;
    private double price;
    private final String categoryId;

    public Product(String id, String name, double price, String categoryId) {
        this.id = id;
        this.name = name;
        this.price = price;
        this.categoryId = categoryId;
    }

    public void updatePrice(double newPrice) {
        if (newPrice <= 0) {
            throw new IllegalArgumentException("El precio debe ser mayor a cero");
        }
        this.price = newPrice;
    }
}

class WriteDatabase {
    private final Map<String, Product> products = new HashMap<>();

    public void save(Product product) {
        products.put(product.getId(), product);
    }

    public Product findById(String id) {
        return products.get(id);
    }
}

// --- Comandos: representan intención de cambio ---

@Getter
@AllArgsConstructor
class CreateProductCommand {
    private final String id;
    private final String name;
    private final double price;
    private final String categoryId;
}

@Getter
@AllArgsConstructor
class UpdatePriceCommand {
    private final String productId;
    private final double newPrice;
}

// --- Modelo de lectura: desnormalizado, listo para mostrar ---

@Getter
class ProductListItem {
    private final String id;
    private final String displayName; // ya incluye el nombre de categoría
    private final String formattedPrice; // ya formateado, sin lógica en el frontend

    public ProductListItem(String id, String displayName, String formattedPrice) {
        this.id = id;
        this.displayName = displayName;
        this.formattedPrice = formattedPrice;
    }
}

class ReadDatabase {
    private final Map<String, ProductListItem> catalogView = new HashMap<>();

    public void upsert(ProductListItem item) {
        catalogView.put(item.getId(), item);
        System.out.println("[ReadDB] Vista de catálogo actualizada: " + item.getDisplayName());
    }

    public List<ProductListItem> searchAll() {
        return new ArrayList<>(catalogView.values());
    }
}

// --- Handler de comandos: valida y persiste en el modelo de escritura ---

@AllArgsConstructor
class ProductCommandHandler {
    private final WriteDatabase writeDatabase;
    private final ProductEventPublisher eventPublisher;

    public void handle(CreateProductCommand command) {
        Product product = new Product(command.getId(), command.getName(), command.getPrice(), command.getCategoryId());
        writeDatabase.save(product);
        eventPublisher.publishProductChanged(product);
    }

    public void handle(UpdatePriceCommand command) {
        Product product = writeDatabase.findById(command.getProductId());
        product.updatePrice(command.getNewPrice());
        writeDatabase.save(product);
        eventPublisher.publishProductChanged(product);
    }
}

// --- Propagación asíncrona hacia el modelo de lectura ---

@AllArgsConstructor
class ProductEventPublisher {
    private final ReadDatabase readDatabase;

    public void publishProductChanged(Product product) {
        // En producción, esto sería un evento a Kafka consumido por un projector separado.
        // Aquí lo simulamos de forma síncrona para simplicidad del ejemplo.
        String formattedPrice = "$" + String.format("%.2f", product.getPrice());
        ProductListItem readModel = new ProductListItem(
                product.getId(),
                product.getName() + " (Categoría: " + product.getCategoryId() + ")",
                formattedPrice
        );
        readDatabase.upsert(readModel);
    }
}

// --- Handler de consultas: solo lee del modelo optimizado ---

@AllArgsConstructor
class ProductQueryHandler {
    private final ReadDatabase readDatabase;

    public List<ProductListItem> getCatalog() {
        return readDatabase.searchAll();
    }
}

// --- Main ---

public class CqrsDemo {

    public static void main(String[] args) {
        WriteDatabase writeDatabase = new WriteDatabase();
        ReadDatabase readDatabase = new ReadDatabase();
        ProductEventPublisher publisher = new ProductEventPublisher(readDatabase);
        ProductCommandHandler commandHandler = new ProductCommandHandler(writeDatabase, publisher);
        ProductQueryHandler queryHandler = new ProductQueryHandler(readDatabase);

        System.out.println("=== Comando: crear producto ===");
        commandHandler.handle(new CreateProductCommand("P-1", "Audífonos inalámbricos", 89.99, "Electrónica"));

        System.out.println("\n=== Comando: actualizar precio ===");
        commandHandler.handle(new UpdatePriceCommand("P-1", 79.99));

        System.out.println("\n=== Query: obtener catálogo (lee del modelo desnormalizado) ===");
        for (ProductListItem item : queryHandler.getCatalog()) {
            System.out.println(item.getDisplayName() + " — " + item.getFormattedPrice());
        }
    }
}
Output esperado:
=== Comando: crear producto ===
[ReadDB] Vista de catálogo actualizada: Audífonos inalámbricos (Categoría: Electrónica)

=== Comando: actualizar precio ===
[ReadDB] Vista de catálogo actualizada: Audífonos inalámbricos (Categoría: Electrónica)

=== Query: obtener catálogo (lee del modelo desnormalizado) ===
Audífonos inalámbricos (Categoría: Electrónica) — $79.99
Notá que ProductQueryHandler nunca toca WriteDatabase ni la entidad Product. Solo conoce el modelo de lectura, ya formateado y listo para mostrar — sin lógica de formateo ni joins en el momento de la consulta.
Para tener en cuenta en producción
- No apliques CQRS a todo el sistema: es un patrón para partes específicas de alta lectura o alta complejidad de consulta. Aplicarlo a un CRUD simple de configuración es sobre-ingeniería — la mayoría de las entidades de tu sistema no lo necesitan.
- La propagación real es asíncrona, con las implicaciones que eso trae: en el ejemplo lo simulamos síncrono por simplicidad, pero en producción el modelo de lectura se actualiza vía Kafka o similar, con un pequeño delay. Tu UI debe poder mostrar “guardando…” en lugar de asumir consistencia inmediata.
- El modelo de lectura puede vivir en tecnología distinta: es común que el write model esté en PostgreSQL y el read model en Elasticsearch (para búsquedas de texto) o en Redis (para lecturas ultra rápidas). CQRS no exige la misma base de datos para ambos lados.
- Combina naturalmente con Event Sourcing y Outbox: si el modelo de escritura usa Event Sourcing, los mismos eventos que reconstruyen el estado sirven para alimentar el modelo de lectura. El Outbox Pattern garantiza que esa propagación de eventos sea confiable.
Conclusión
CQRS no es sobre tener dos bases de datos por el gusto de complicar la arquitectura — es sobre reconocer que forzar un único modelo a servir dos necesidades muy distintas (integridad en la escritura, velocidad en la lectura) siempre termina en compromisos incómodos para ambos lados.
Separarlos permite optimizar cada uno para lo que realmente necesita.
Como con casi todos los patrones de esta serie: la complejidad extra solo vale la pena cuando el problema que resuelve es real.
Si tu sistema no sufre de esta tensión entre lecturas y escrituras, un solo modelo sigue siendo la opción correcta.
Recordá suscribirte aquí para recibir los próximos posts directamente en tu correo.
Referencias:
Implementing Domain-Driven Design — Vaughn Vernon
Martin Fowler — CQRS: https://martinfowler.com/bliki/CQRS.html